ここ数年、ビジュアルAIは主に生成された画像や動画の見た目で評価されてきました。最終的な画像や動画の見栄えが良いほど、そのモデルも優れていると見なされていたのです。
これは理にかなっていました。拡散モデルは、テキストのプロンプトから美しい画像、動画、さらにはますます現実味を増した世界を生成できるようになりました。比較対象として分かりやすかったのはPhotoshopやカメラでした。
しかし、グラフィックデザイン、UIデザイン、3Dモデリングなど、さまざまなビジュアル関連タスクでユーザーが求めているのは、完成した画像だけではありません。フィードバックや新しいアイデアをもとに、イテレーションを重ねていけるアーティファクトを求めているのです。デザイナーが求めるのはモックアップだけでなく、レイヤーやコンポーネント、引き継ぎ可能なデータです。アニメーターに必要なのは動画だけでなく、タイミングカーブやキーフレーム、編集可能なモーションです。3Dアーティストも、レンダリング済みの画像にとどまらず、ジオメトリ、マテリアル、ライティング、カメラ、そしてシーン構成を必要としています。
最近注目を集めるビジュアルAIツールは、最終出力そのおのではなく、その背後にあるソースコードを生成するようになりました。これにより、編集の柔軟性が高まり、イテレーションやフィードバックループも、ピクセルネイティブなモデルでは実現できない水準へと進化しています。
2つのビジュアル生成スタック
ビジュアル生成には、大きく分けて2つの手法があります。
1つ目は「ピクセルネイティブ生成」です。通常は潜在空間で画像や動画を直接生成する手法です。質感、雰囲気、照明、写実性に優れています。映画のようなショット、美しいムードボード、写真のようにリアルな画像を生成するなら、拡散モデルが今も主流です。
2つ目は「コードネイティブ生成」です。別のエンジンが実行またはレンダリングするための表現を生成する手法です。モデルが直接生成するのは、最終的な画像ではなく、その画像を生み出すプログラムです。
このプログラムは、SVGファイル、HTML/CSSのレイアウト、Reactコンポーネント、LottieのJSONファイル、Blenderのスクリプト、USDのシーングラフ、シェーダー、ゲームエンジンのシーンなど、さまざまな形を取ります。最終的に出力されるのは画像ですが、その基盤にあるのは構造化された表現です。
この2つの手法の違いは大きな意味を持ちます。実際の制作工程では、生成後の処理が欠かせないためです。生成画像は出力結果として有用ですが、生成されたビジュアルプログラムは編集、再利用、改良、バージョン管理ができるアーティファクトとして役立ちます。他のソフトウェアスタックと組み合わせ、制約条件を満たしているか検証することもできます。条件を変えて何度もレンダリングしたり、デザイナー、エンジニア、エージェントの間で引き継いだりすることも可能です。
この大きな変化はすでに始まっていると私は考えています。ビジュアル生成の課題の一部は、コーディングの課題として捉え直せます。明確に定義し、結果を検証できるコーディングの課題として解決すれば、効率的に改良を進められるようになります。
ビジュアル課題を解くコード
ビジュアルコード生成の価値を理解するには、最初のドラフトができた後の工程を考えるのが近道です。
例えば、モデルでロゴを生成したとします。出力されたラスター画像で曲線が1ヵ所でも間違っていれば、その部分をマスクしてインペイントするか、再生成するか、あるいは手作業で描き直す必要があります。一方、出力がSVGであれば、パス、基本図形、グラデーション、線、テキスト要素を編集できます。これは、デザイナーがQuiverでロゴを制作する際に採用している方法です。


UIデザインでは、出力がスクリーンショットであれば、主にアイデアの参考として使うことになります。HTML/CSSやReactで出力されれば、デザイナーはDOMを確認し、実際に使用するコンポーネントに置き換え、レスポンシブデザインやアクセシビリティを検証し、アプリケーションに組み込めます。
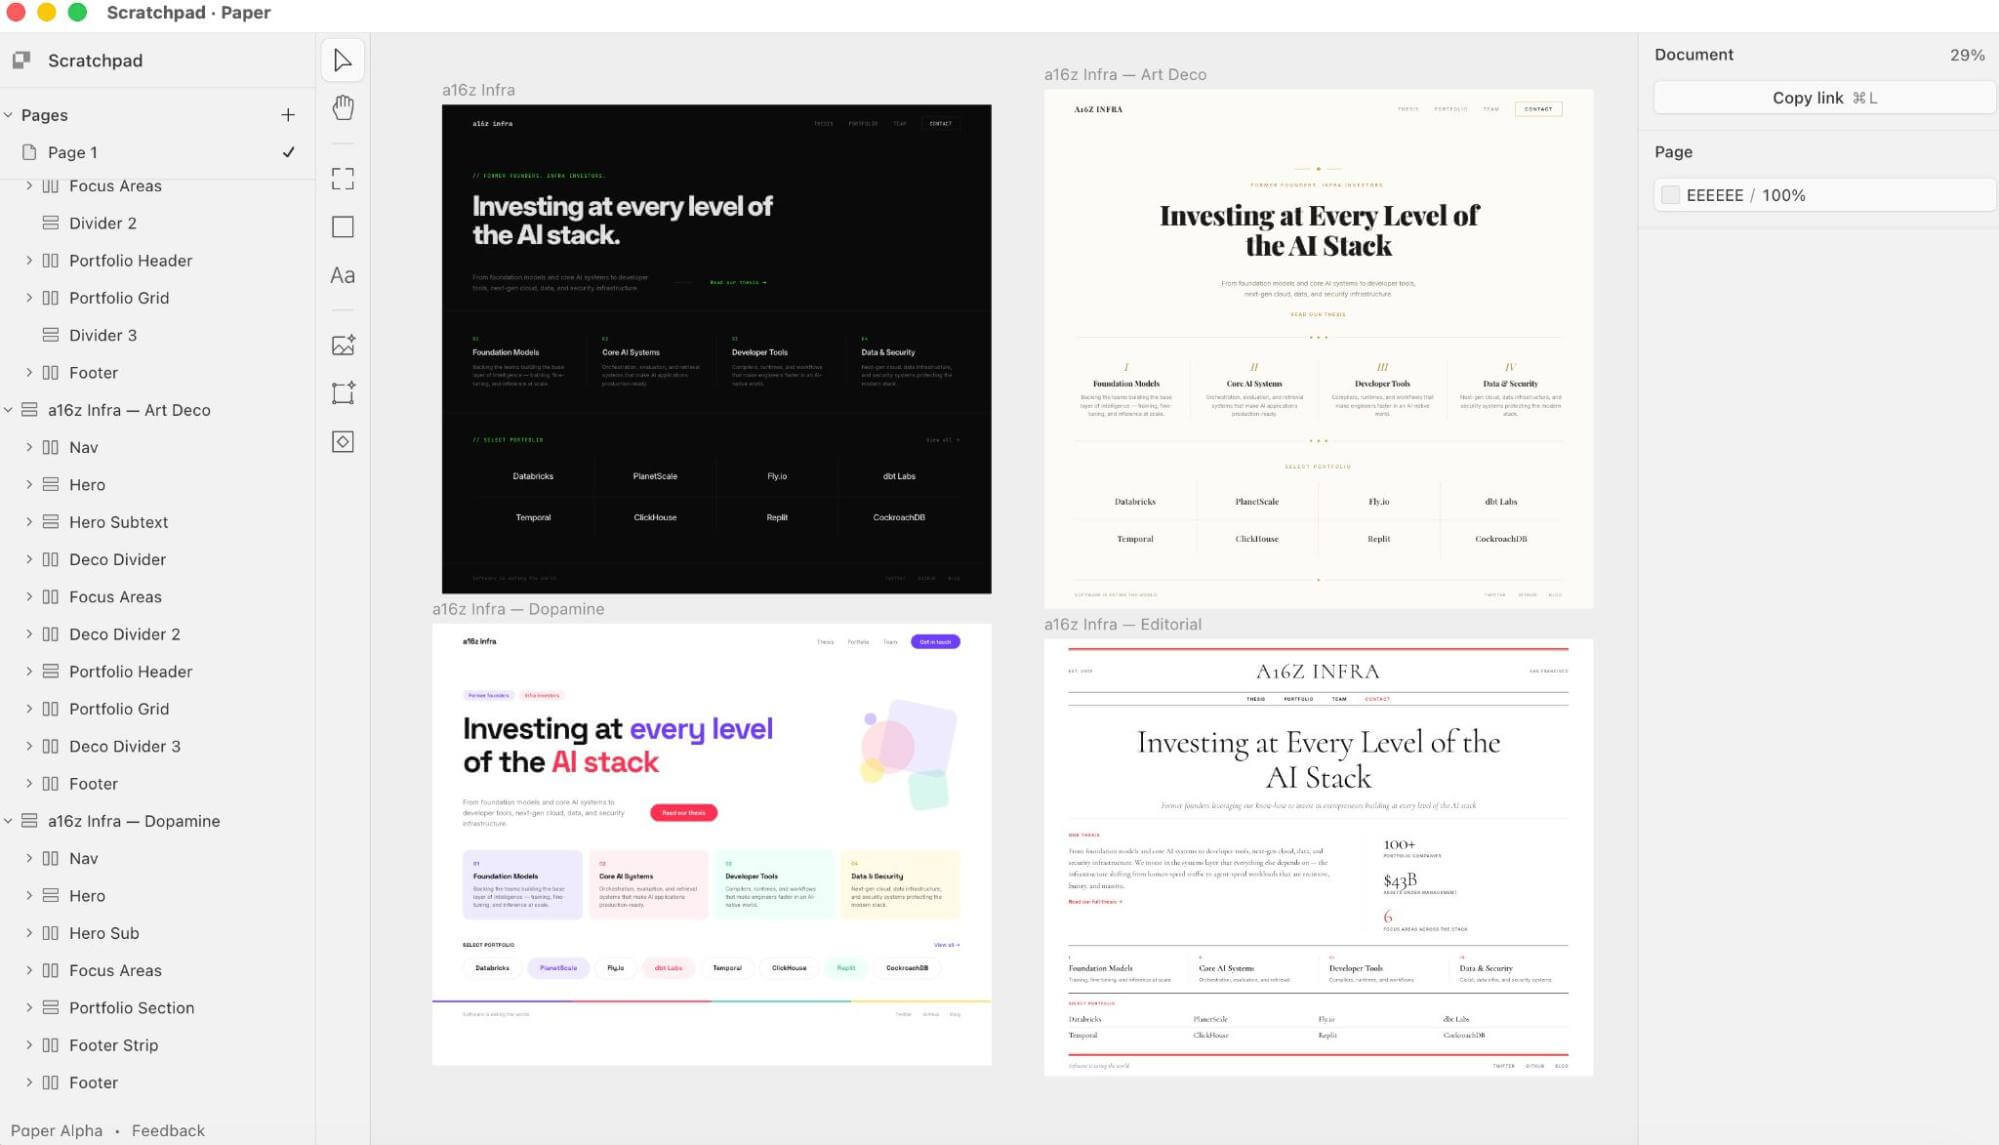
Paperのスクリーンショット(すべてのビジュアルをコードで表現)
この点も、ビジュアルコード生成が推論時計算という観点から特に興味深い理由の一つです。ピクセルネイティブ生成で、推論を増やすと、概して出力サンプルが増えます。画像を20枚生成して最適なものを選び、場合によってはもう一度試す、といった進め方です。これは有用ではありますが、試すたびにサイコロを振り直しているようなものです。モデルはフィードバックに応じて生成できますが、そのフィードバックは画像全体に対するもので具体性に欠けます。
技術的には、拡散モデルも推論時計算の恩恵を受けられます。例えば、「Inference-time Scaling of Diffusion Models through Classical Search(古典的探索による拡散モデルの推論時スケーリング)」と題した論文では、推論時の探索によって、プランニング、RL(強化学習)、画像生成の各分野で拡散モデルの出力を改善できることが示されています。しかし、そこで働くフィードバックループは異なります。拡散モデルでは通常、潜在空間での生成経路や生成済みのサンプルを探索します。報酬によって、ある出力が別の出力より優れているとモデルに伝えることはできますが、フィードバックを具体的なソースレベルの編集に結びつけることはできません。
コードネイティブ生成では、より高精度なループを実現できます。
コード → レンダリング → 検査 → 修正
このモデルはアーティファクトを生成・レンダリングして、問題点を検査し、ソースを修正します。間隔がおかしければCSSを変更し、ロゴの曲線がずれていればSVGのパスを編集します。アニメーションが遅く感じられればタイミングを調整します。重要な点は、イテレーションのたびに、レンダリング結果だけでなく、元のアーティファクトが改善されることです。そのため、ビジュアルコード生成では、生成トークンや推論時計算を増やすことが、改善に直結します。このモデルは単に画像のサンプルを増やすのではなく、結果を検証できるクローズドループ環境でビジュアル生成プログラムをデバッグしているのです。
コードによるビジュアル生成スタック
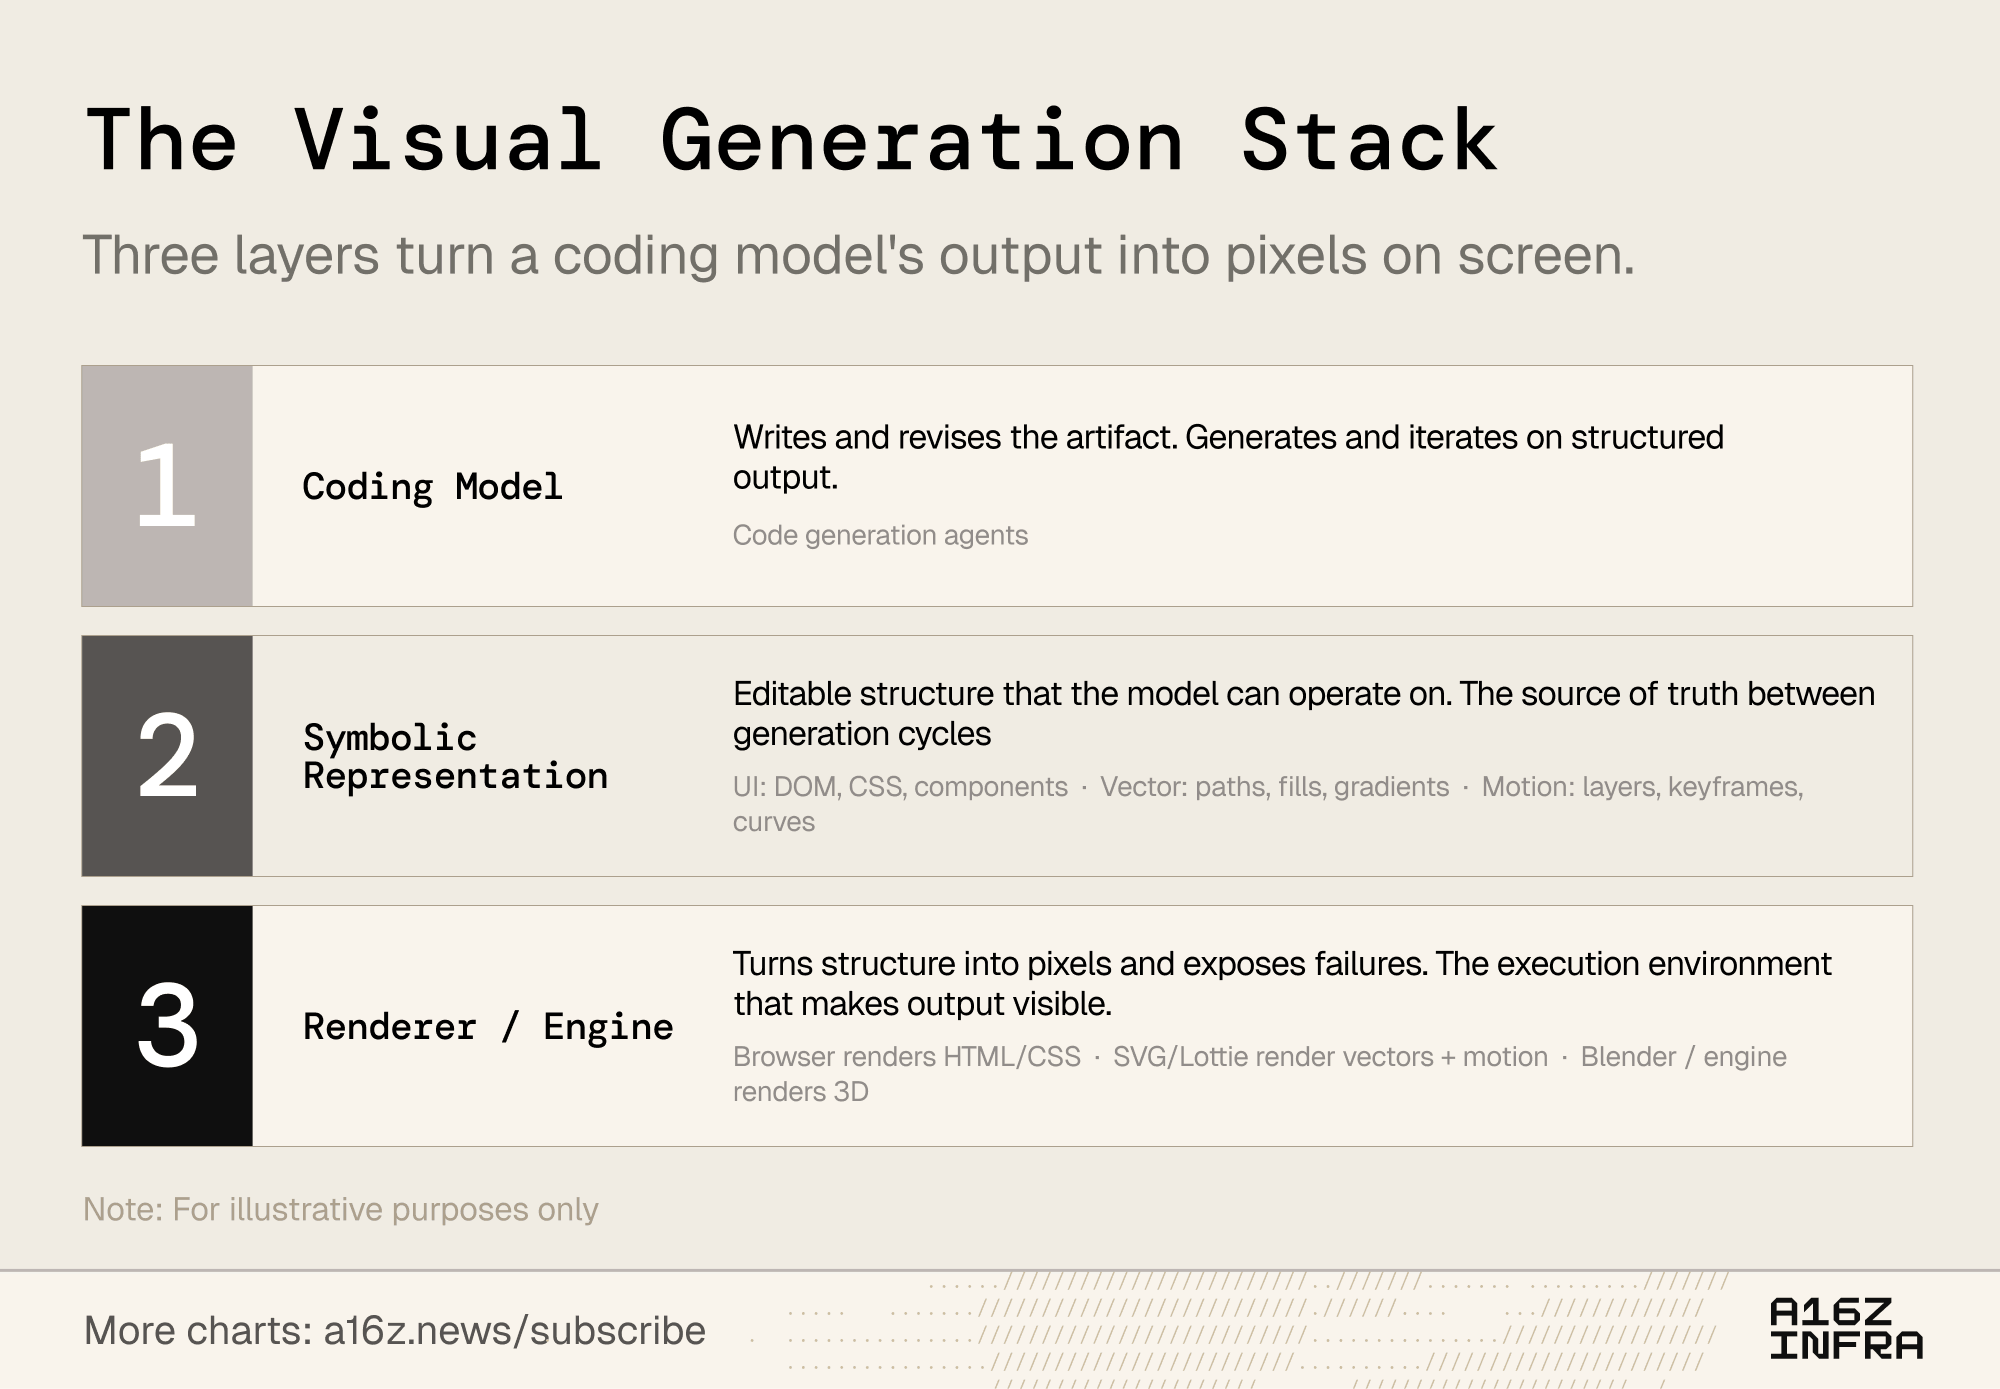
上記の例を支えているのは、次のスタックです。
コーディングモデル+記号表現+レンダラーまたはエンジン
| The Visual Generation Stack | ビジュアル生成スタック |
| Three layers turn a coding model’s output into pixels on screen. | 3つのレイヤーが、コーディングモデルの出力を画面上のピクセルに変換 |
| Coding Model | コーディングモデル |
| Writes and revises the artifact. Generates and iterates on structured output. | アーティファクトを記述・修正。構造化された出力を生成し、イテレーションを実行。 |
| Code generation agents | コード生成エージェント |
| Symbolic Representation | 記号表現 |
| Editable structure that the model can operate on. The source of truth between generation cycles | モデルが操作できる編集可能な構造。生成サイクル間で引き継がれる基本データ |
| UI: DOM, CSS, components • Vector: paths, fills, gradients • Motion: layers, keyframes, curves | UI:DOM、CSS、コンポーネント • ベクター:パス、塗り、グラデーション • モーション:レイヤー、キーフレーム、カーブ |
| Renderer / Engine | レンダラー/エンジン |
| Turns structure into pixels and exposes failures. The execution environment that makes output visible. | 構造をピクセルに変換し、問題を可視化。出力を可視化する実行環境。 |
| Browser renders HTML/CSS • SVG/Lottie render vectors + motion • Blender / engine renders 3D | ブラウザーがHTML/CSSをレンダリング • SVG/Lottieがベクターとモーションをレンダリング • Blenderやエンジンが3Dをレンダリング |
| Note: For illustrative purposes only | 注:この図はイメージです |
| More charts: a16z.news/subscribe | その他のグラフ:a16z.news/subscribe |
| A16Z INFRA | A16Z INFRA |
このコーディングモデルはアーティファクトの生成と編集を担い、HTML、SVG、LottieのJSON、Blenderのスクリプト、USDのシーン、あるいは用途に合わせた3Dアセット用のプログラムを書きます。
記号表現はすべての基本となる元データです。これがあるからこそ、アーティファクトを編集できます。UIにはDOMノード、レイアウトルール、コンポーネントがあります。Lottieアニメーションには、レイヤー、ベクター図形、タイミングカーブ、キーフレーム、モーションのパラメーターがあります。3Dアセットには、ジオメトリ、マテリアル、ジョイント、制約、階層構造があります。
レンダラーやエンジンは、その構造をピクセルに変換します。ブラウザーはHTML/CSSをレンダリングし、SVGレンダラーはベクターをレンダリングします。Lottieプレーヤーはモーションをレンダリングし、Blenderやゲームエンジンは3Dシーンをレンダリングします。シミュレーターは、関節構造を持つアセットの動きや相互作用を検証します。
記号表現の重要性を示す好例が、OmniLottieです。Lottieは、JSONをベースにした軽量なアニメーション形式です。モーションを単なる動画ではなく、編集可能なベクター図形、レイヤー、キーフレーム、タイミングのパラメーターとして表現します。OmniLottieは、このLottieのJSONをモデルに扱いやすいコマンドシーケンスに変換し、モデルがLottieアニメーションをより確実に生成・編集できるようにするフレームワークです。その狙いは、フルエージェント型のループを構築することではなく、Lottieをよりモデルネイティブにすることです。つまり、LottieのJSONを、モデルが生成できるコンパクトなコマンドとパラメーターのシーケンスに変換することです。Lottieがもともと編集可能な形式であることが、ここで重要になります。モーションを図形、レイヤー、タイミング、アニメーションのパラメーターとして表せば、フィードバックをソースレベルの編集に結び付けられます。オブジェクトの動きが遅すぎる場合はタイミングを調整し、パスが間違っていればベクターを編集し、モーフィングに問題があれば図形のシーケンスを修正します。
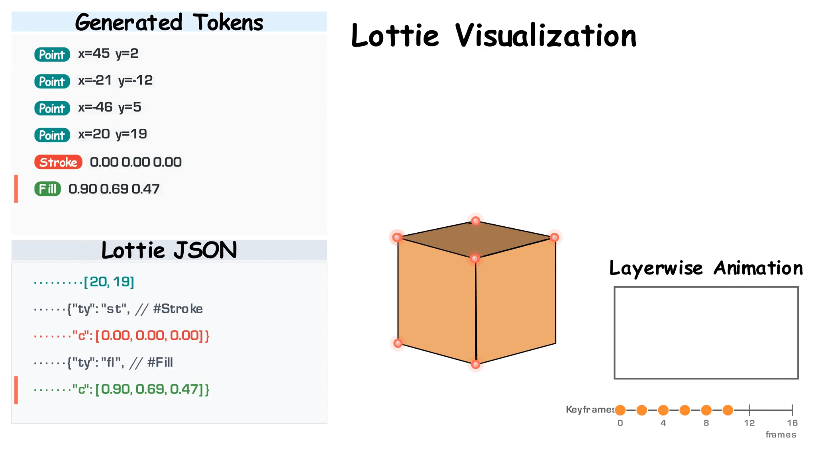
OmniLottieのプロジェクトサイトに掲載された動画
このスタックは、コーディングエージェントが出力品質を高めるために実行できる推論時計算のループに対応しています。「コード→レンダリング→検査→修正」のループのたびに、モデルは新たなサンプルを生成するだけでなく、レンダラーからのフィードバックをもとにアーティファクトを改良します。CSSのルール変更、SVGのパス調整、アニメーションのタイミング修正、3D制約の更新などを経て再度レンダリングし、改善を続けます。
このようなループを経て、求める結果に近づく可能性が生まれます。ピクセルネイティブ生成では再試行のたびに新しい出力が生まれることが多いですが、コードネイティブ生成では再試行のたびに、元のアーティファクトを改善できます。このモデルは画像や動画のサンプルを増やすだけではありません。クローズドループのレンダリング環境でビジュアル生成プログラムをデバッグしているのです。
実行環境別の市場マップ
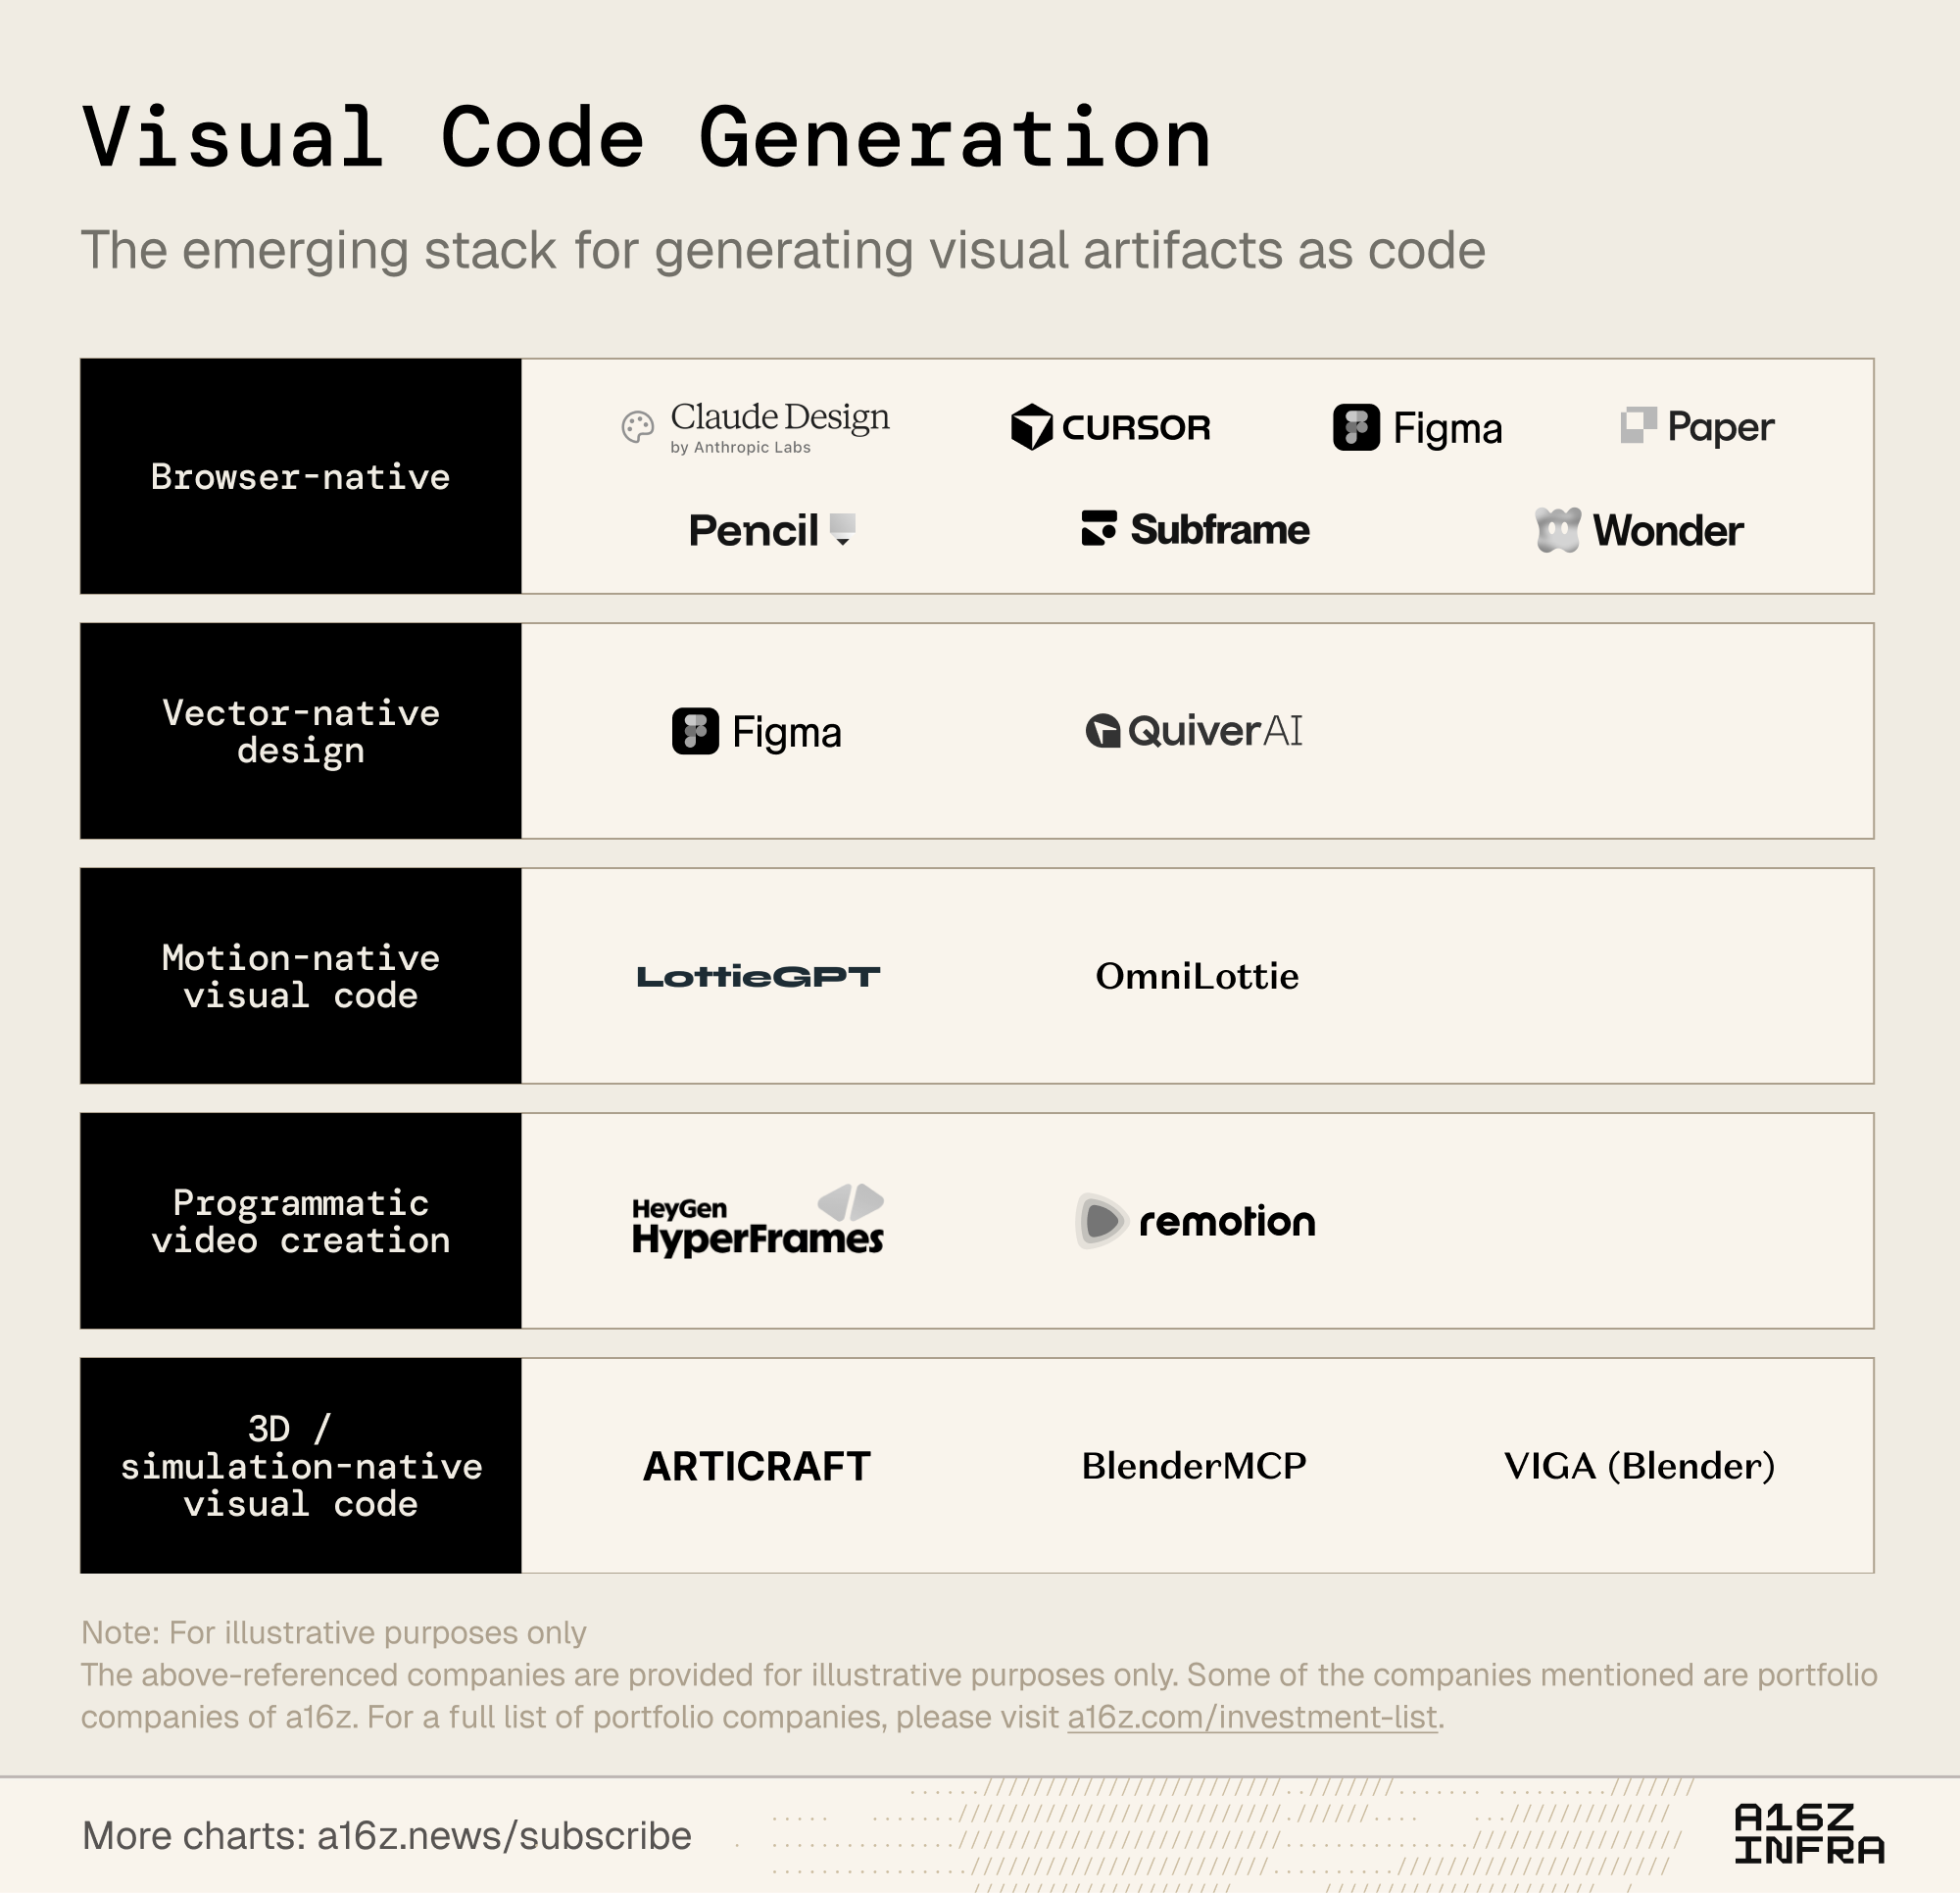
ビジュアルコード生成の市場は、アーティファクトをレンダリングまたは実行する環境を軸に形成され始めています。コードネイティブのビジュアル生成では、モデルが記号表現で構成されたアーティファクトを生成し、それをブラウザー、SVGレンダラー、Lottieプレーヤー、Blender、ゲームエンジン、シミュレーターなどで実行します。
実行環境によってソースの表現形式やフィードバックループ、制作ワークフローが異なるため、市場参入の切り口も異なります。
| Visual Code Generation | ビジュアルコード生成 |
| The emerging stack for generating visual artifacts as code | ビジュアルアーティファクトをコードとして生成する新たなスタック |
| Browser-native | ブラウザーネイティブ |
| Claude Design | Claude Design |
| by Anthropic Labs | by Anthropic Labs |
| CURSOR | CURSOR |
| Figma | Figma |
| Paper | Paper |
| Pencil | Pencil |
| Subframe | Subframe |
| Wonder | Wonder |
| Vector-native design | ベクターネイティブのデザイン |
| Figma | Figma |
| QuiverAI | QuiverAI |
| Motion-native visual code | モーションネイティブのビジュアルコード |
| LottieGPT | LottieGPT |
| OmniLottie | OmniLottie |
| Programmatic video creation | プログラムによる動画制作 |
| HeyGen | HeyGen |
| HyperFrames | HyperFrames |
| Remotion | remotion |
| 3D / simulation-native visual code | 3D/シミュレーションネイティブのビジュアルコード |
| ARTICRAFT | ARTICRAFT |
| BlenderMCP | BlenderMCP |
| VIGA (Blender) | VIGA (Blender) |
| Note: For illustrative purposes only | 注:この図はイメージです |
| The above-referenced companies are provided for illustrative purposes only. Some of the companies mentioned are portfolio companies of a16z. For a full list of portfolio companies, please visit a16z.com/investment-list. | 上記の企業はあくまでも例として掲載しています。一部にはa16zのポートフォリオ企業が含まれます。ポートフォリオ企業の一覧は、a16z.com/investment-listをご覧ください。 |
| More charts: a16z.news/subscribe | その他のグラフ:a16z.news/subscribe |
| A16Z INFRA | A16Z INFRA |
現時点で最も顕著な用途は2Dデザイン、特にUIデザインとグラフィックデザインですが、ビジュアルコード生成の適用範囲はデザインツールにとどまりません。ビジュアルアーティファクトの基盤となる表現を生成、レンダリング、検査、改良できる分野で、幅広く応用できます。
次の重要なフロンティアは3D
現時点で最も顕著な用途はプロダクトデザインと2Dデザインですが、一貫性の確保という課題をコーディングの課題として捉え直すことで最も大きな恩恵を受けられるのは、3Dアーティファクトかもしれません。
2Dデザインは、見た目さえ整っていれば十分な場合もあります。しかし3Dアセットはそうではありません。椅子をレンダリングした画像は椅子そのものではなく、単なる椅子の絵にすぎません。ゲーム、シミュレーション、3D編集ツールで活用できるアセットにするには、その元となる3D表現に一貫性があり、ジオメトリ、マテリアル、パーツの階層構造、シーンのコンテキストが適切でなければなりません。
だからこそ、3Dはビジュアルコード生成に適しています。重要なのは、ある角度から3Dに見えるものを生成することではありません。視点を変えても、編集しても、他のものと相互作用させても整合性を保てる3D構造を生成することです。そのためには、イテレーションを重ねるループが求められます。オブジェクトを提案し、レンダリングしたら、ジオメトリやパーツが適切かを確認し、元の表現を修正するというループです。ただし、このループを機能させるには、エージェントに適切なツールとコンテキストを与える必要があります。見た目が良くなるまでBlenderを実行し続けるだけでは不十分です。カメラの視点を変え、シーンの状態を確かめ、オブジェクトを分離し、目標と比較し、試行履歴を記憶し、視覚的な不一致をソースレベルの編集に反映する手段がエージェントには必要です。このような手段が揃ってこそ、推論時計算が望ましい結果につながります。
多くのアセットにとって、視覚的な一貫性は最低限の要件にすぎません。オブジェクトには、適切なパーツのセマンティクスと機能的な制約も必要です。ドアは開き、蝶番は回転し、引き出しはスライドし、車輪は回らなければなりません。つまり、出力はそれらしい形状をしているだけでなく、実物と同じように動作する必要があります。
この点で、VIGAやArticraft3Dのようなプロジェクトは業界の注目を集めています。今年は、商用・オープンソースの両方で、さらに多くの取り組みが登場すると期待しています。VIGAは、レンダリングとフィードバックの環境としてBlenderを使い、ビジュアルの再構築を「コード→レンダリング→検査」のループに落とし込みます。Blenderをそのままエージェントに使わせ、ループに組み込むだけではありません。観察と修正に役立つセマンティックツールと試行履歴をエージェントに提供し、より適切な視点から検査し、問題点を診断して、的を絞った編集を行えるようになります。Articraft3Dは、より直接的にアセットの構造に取り組みます。関節構造を持つ3Dを生成するために、パーツ、ジオメトリ、ジョイント、テストを定義するプログラムを書くのです。
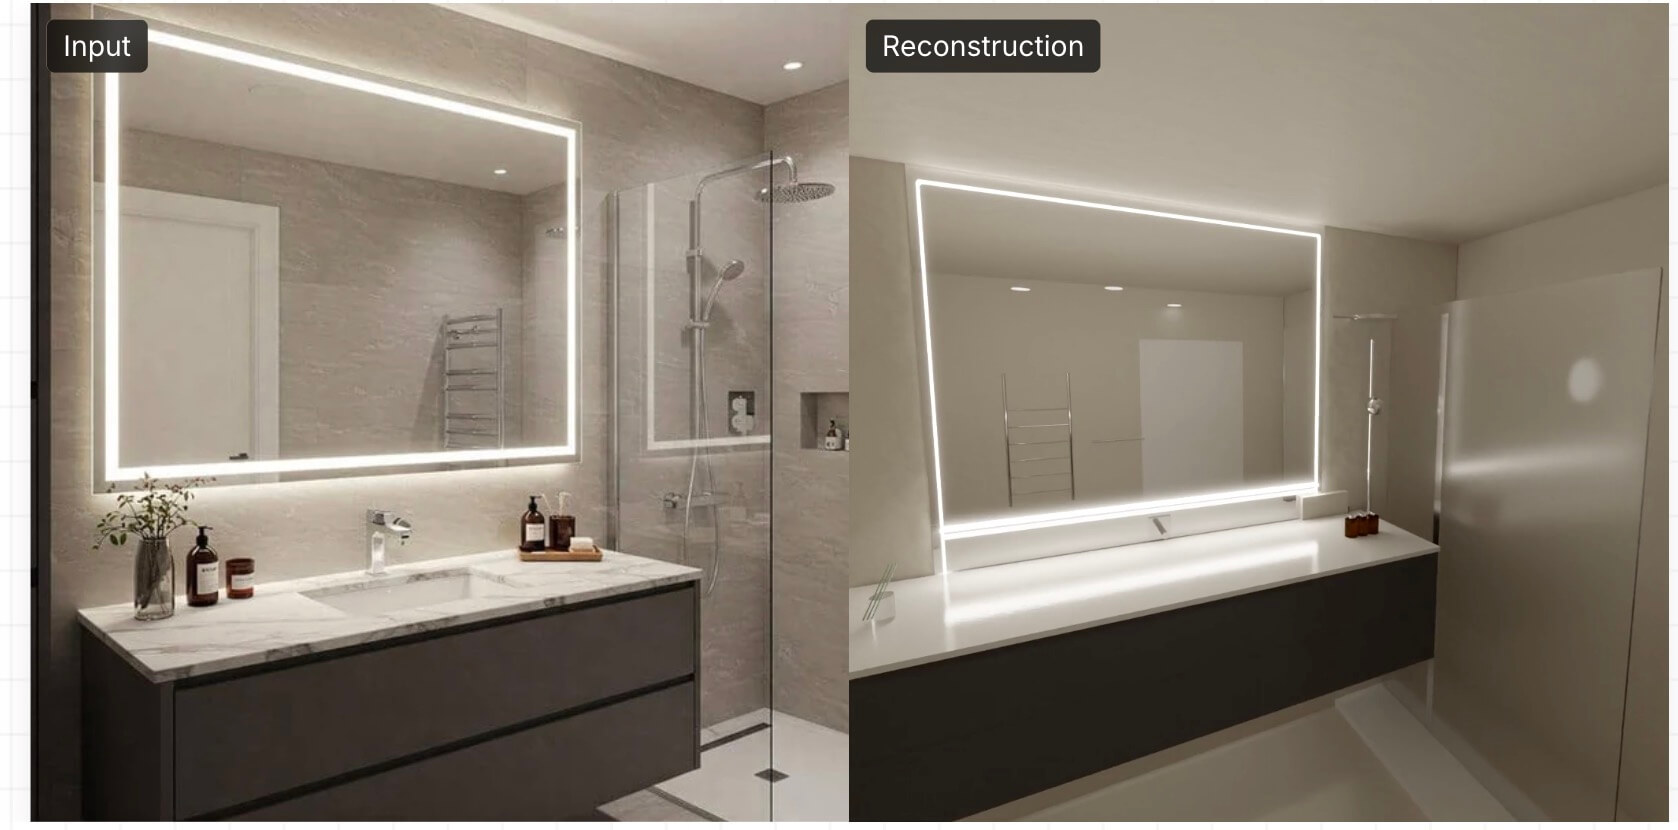
VIGAが生成した3Dシーンの再構築例
| Input | 入力した画像 |
| Reconstruction | 再構築した結果 |
VIGAが生成した3Dシーンの再構築例
今後の展望と未解決の課題
ビジュアルコード生成が成功すれば、勝ち残る製品は、より美しい出力を生成するだけではありません。アーティファクトの生成・レンダリングから問題点の検査、ソースの修正に至るまでのループ全体を担うようになります。
これにはいくつかの影響があります。第一に、レンダラーがフィードバック環境になります。現在のコーディングエージェントがサンドボックスや仮想マシンを活用するように、ブラウザー、SVGレンダラー、Lottieプレーヤー、Blender、ゲームエンジン、シミュレーターが、エージェント自身の成果をテスト・改善する環境になります。
第二に、イテレーションのコンテキストの質がこれまで以上に重要になります。エージェントに、ビジュアルコード版「ラルフループ」に相当する処理を実行させるには、次の一手を導く高精度な中間表現が必要です。モデルは、見た目のどこかがおかしいと認識するだけでなく、ソースのどの部分をなぜ変更すべきなのかを把握しなければなりません。構造、レンダリング、フィードバックのささいな誤りが、イテレーションを重ねるうちに急速に蓄積していくこともあります。
第三に、今後はピクセルネイティブモデルとコードネイティブモデルを組み合わせるハイブリッド方式が主流になる可能性があります。写実性、質感、探索では、ピクセルネイティブモデルが依然として最適です。構造、イテレーション、実制作の面では、コードネイティブシステムに優位性があるでしょう。そこで、最も有用なのは、両者を組み合わせたワークフローです。
まだ答えの出ていない問いも残っています。それぞれの領域で、どの表現形式が主流になるのでしょうか? 前世代のエンジンやレンダラーを流用するのではなく、新たにつくり直す必要があるのでしょうか?制約、テスト、フィードバックループによって、ビジュアルの好みをどの程度まで捉えることができるでしょうか?
とはいえ、方向性は明確です。ビジュアルAIは出力そのものの生成から、コードで表現されたアーティファクトの生成へと移行しつつあります。第一の波では、画像の生成が容易になりました。次の波では、編集、テスト、リリース、改良が可能なビジュアルアーティファクトの生成が容易になるでしょう。
今こそ、この分野に取り組むべきときです。関連する表現形式を開発している方、研究に携わっている方、業界の今後についてご意見をお持ちの方は、yli@a16z.comまでご連絡ください。
